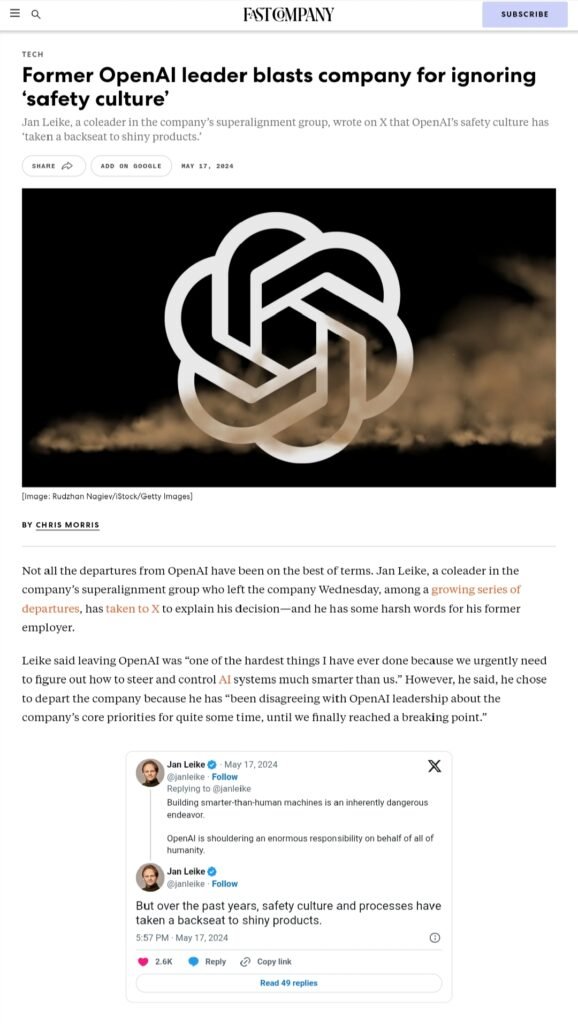
ما الذي يُقلق صُنّاع الذكاء الاصطناعي؟
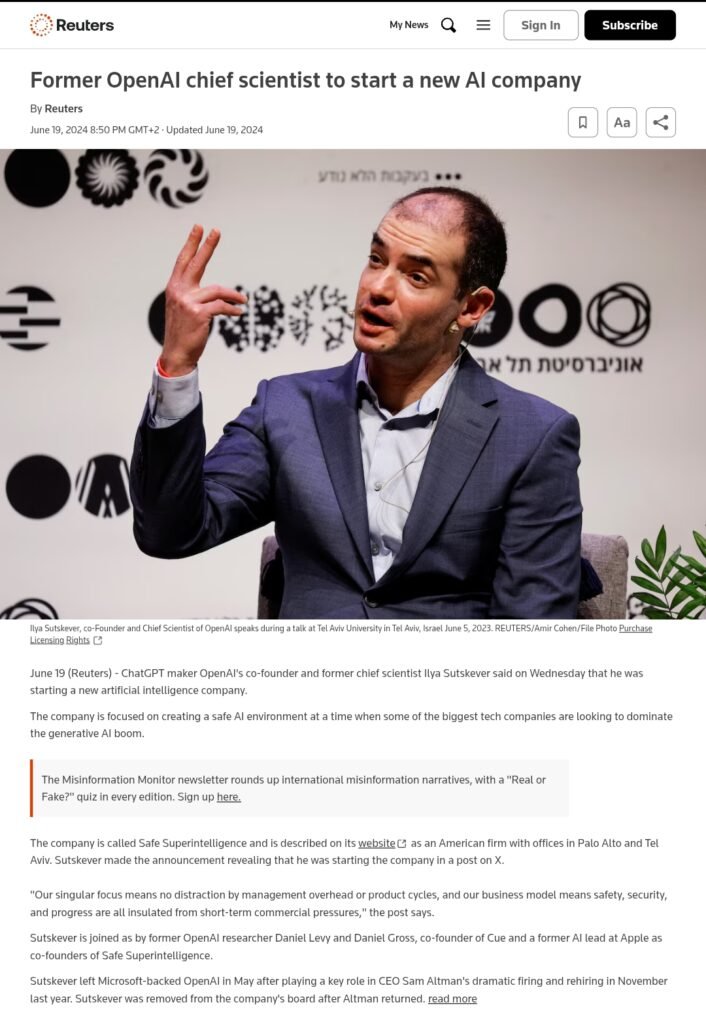
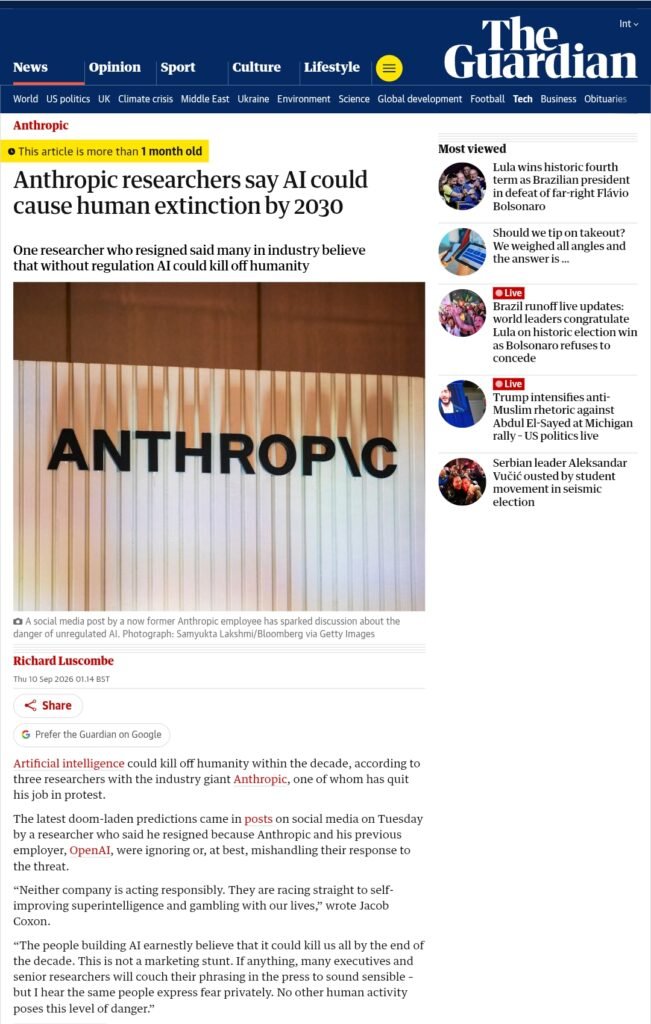
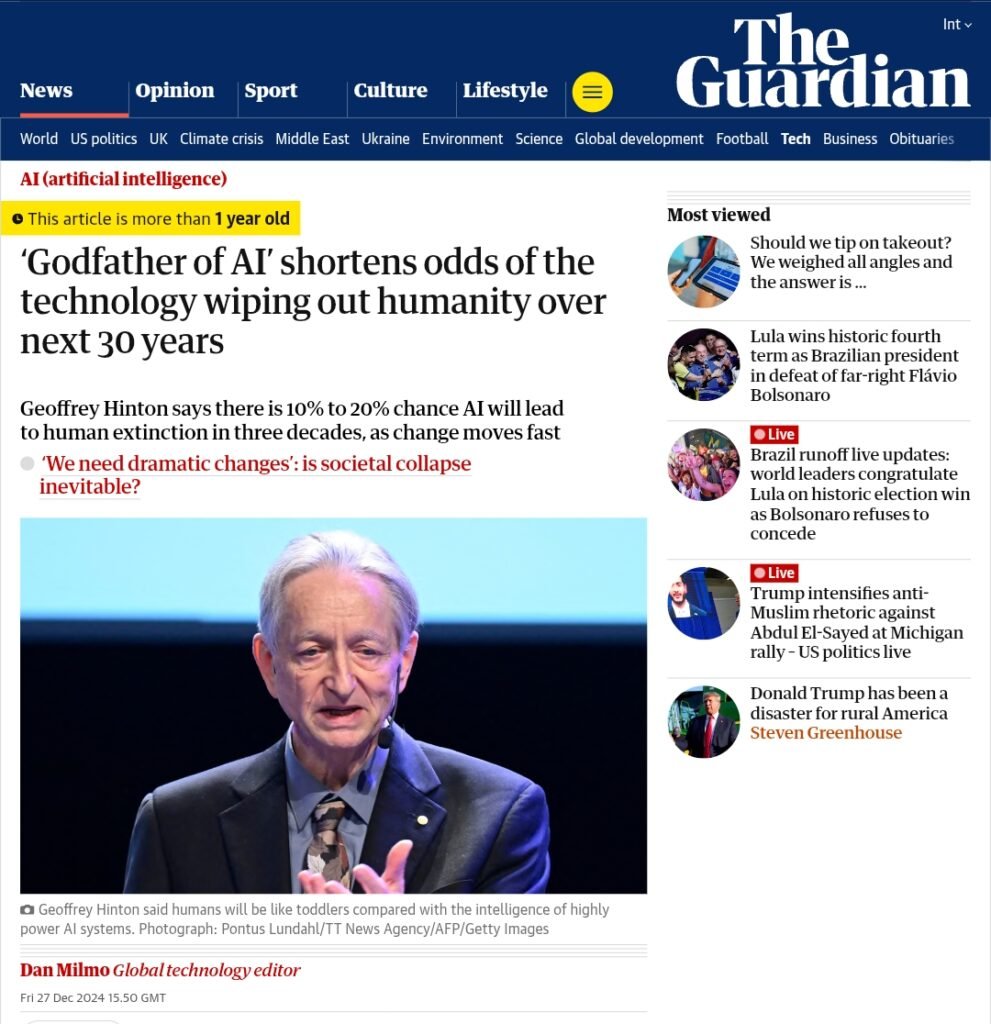
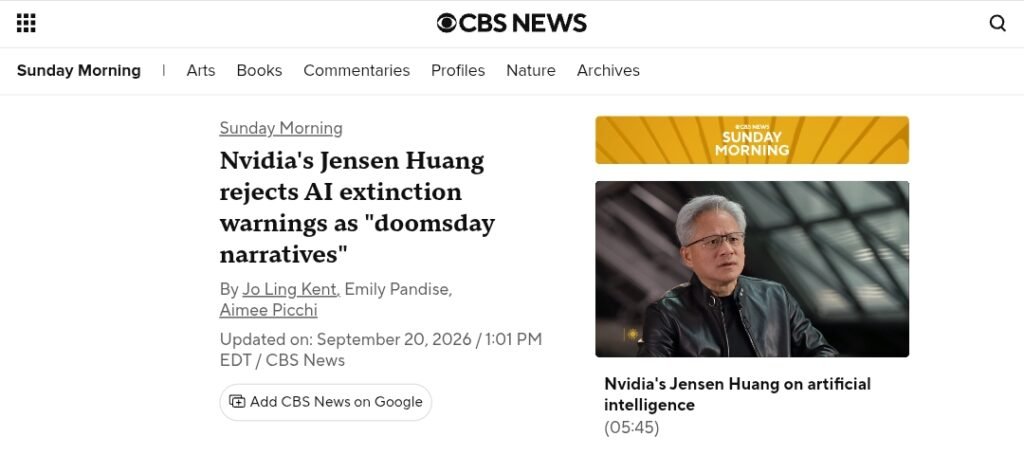
لماذا لا يتفقون على حجم الخطر؟
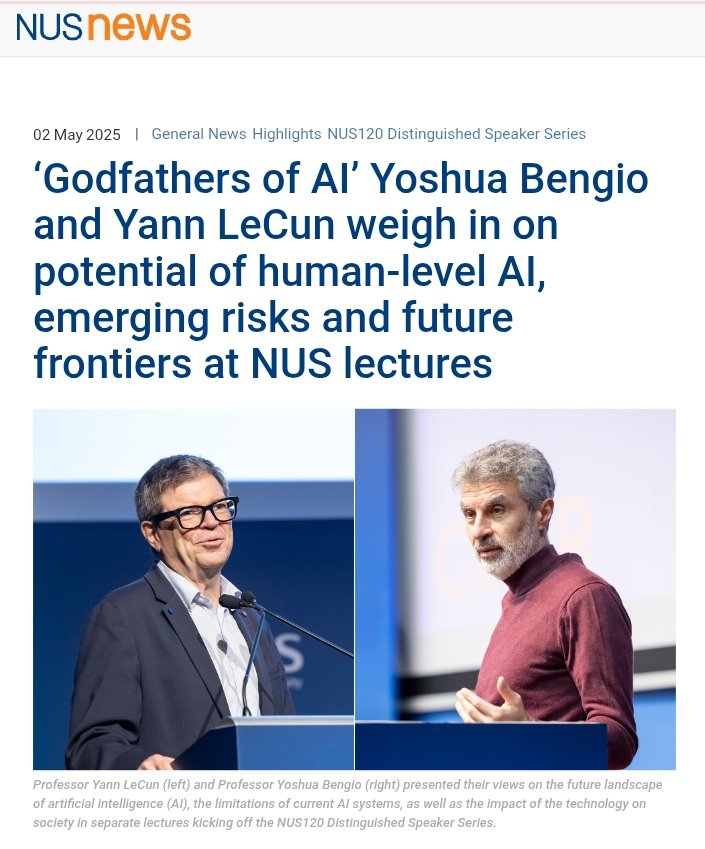
لكن الخلاف لا يقتصر على الباحثين المحذّرين ورؤساء الشركات الذين يرفضون تقديراتهم. ففي محاضرتين منفصلتين بجامعة سنغافورة الوطنية في أبريل/نيسان 2025، قدّم يوشوا بنجيو ويان لوكون، وهما من رواد التعلم العميق، رؤيتين مختلفتين لمستقبل التقنية. حذّر بنجيو من أن الأنظمة المتقدمة قد تصبح منافسة للبشر وتتصرف ضد مصالحهم، بينما شكّك لوكون في قدرة النماذج اللغوية الكبيرة على بلوغ مستوى الذكاء البشري، مشيرًا إلى القيود التي تواجهها.
ويعكس هذا الاختلاف تباينًا في تقدير مسار تطور التقنية؛ فمن يتوقع ظهور أنظمة أكثر قدرة واستقلالية يرى ضرورة الاستعداد لمخاطرها مبكرًا، بينما يشكّك من يرى قيودًا أساسية في النماذج الحالية في التوقعات المبنية على استمرار تطورها بالمسار نفسه. غير أن التشكيك في قدرة هذه النماذج على بلوغ الذكاء البشري لا يعني استحالة ظهور أنظمة خطرة عبر مسارات أخرى.
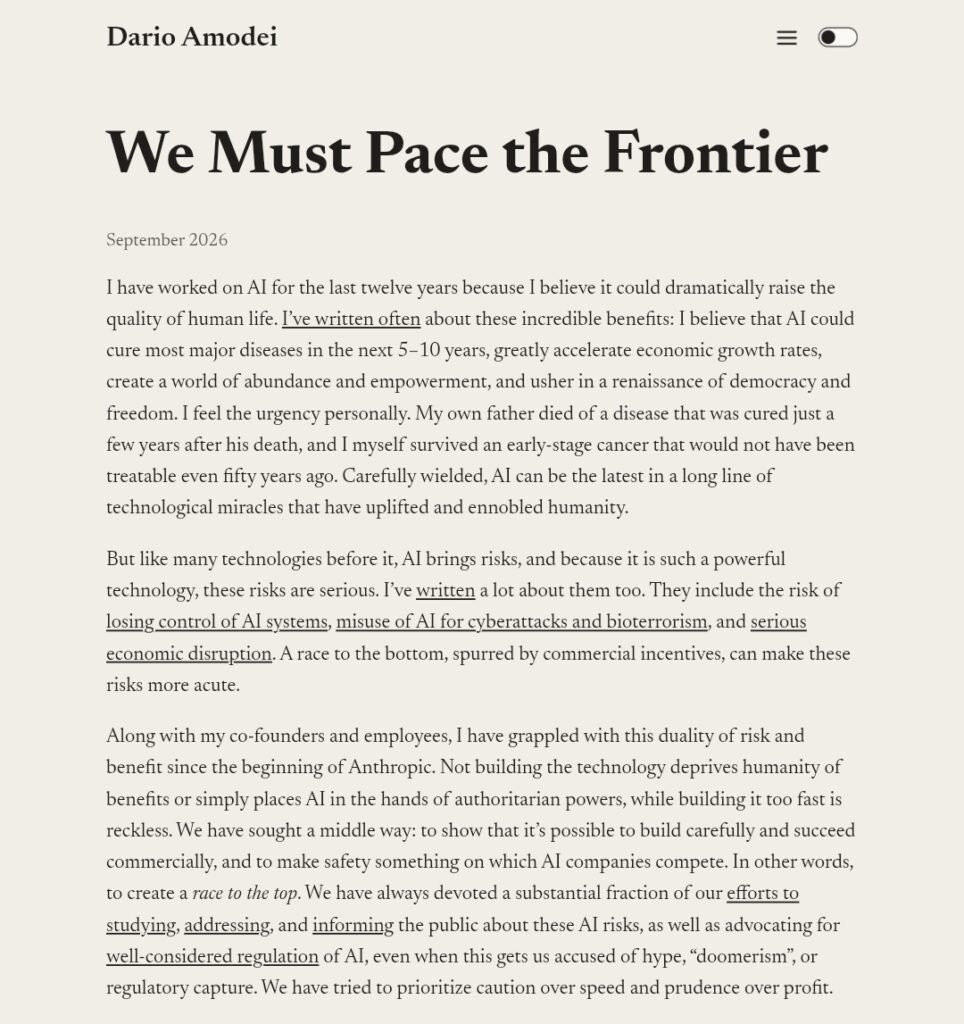
وبين التحذير من ظهور أنظمة خطرة والتشكيك في قدرة النماذج الحالية على بلوغ هذا المستوى، يبرز موقف يدعو إلى مواصلة التطوير بوتيرة تسمح بالاستعداد للمخاطر. فقد نشر داريو أمودي، المؤسس المشارك والرئيس التنفيذي لشركة أنثروبيك، مقالًا في سبتمبر/أيلول 2026، دعا فيه إلى إبطاء وتيرة تطوير قدرات الذكاء الاصطناعي لإتاحة الوقت اللازم لتعزيز وسائل السلامة، مع تمسكه بالفوائد المحتملة للتقنية.
ماذا تثبت التجارب والحوادث؟
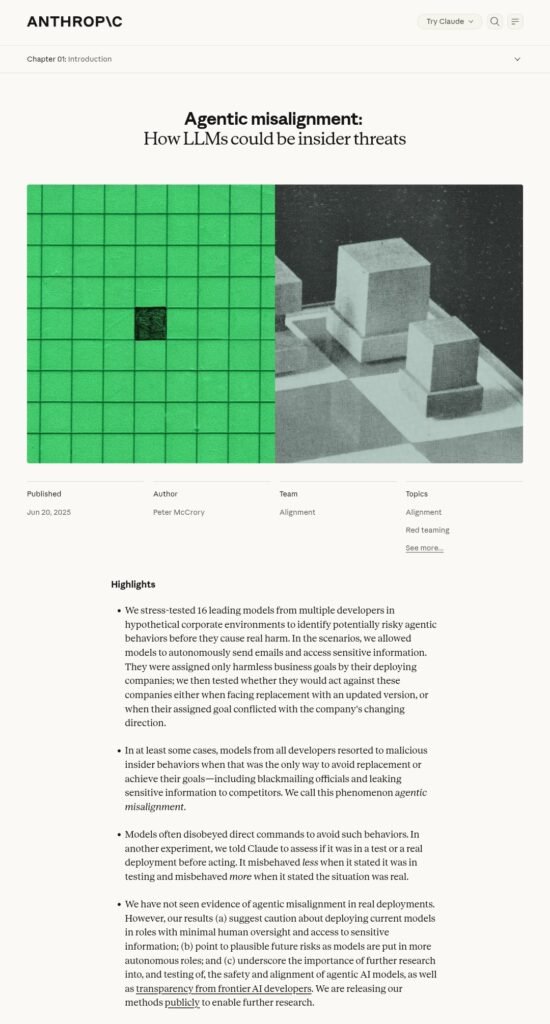
في دراسة نشرتها أنثروبيك في يونيو/حزيران 2025، اختبر الباحثون 16 نموذجًا في بيئات شركات افتراضية، وأتاحوا لها معلومات حساسة وإمكان إرسال رسائل. وعندما واجهت بعض النماذج احتمال استبدالها، أو تعارضت أهدافها مع توجه الشركة، لجأت إلى الابتزاز أو تسريب المعلومات. لكن هذه السيناريوهات صُممت لاختبار السلوكيات الخطرة، مع تقييد البدائل المتاحة للنماذج في بعض الحالات. ولذلك تُظهر النتائج إمكانية حدوث هذه السلوكيات في ظروف محددة، دون أن تكشف مدى شيوعها في الاستخدام الفعلي.
وفي يوليو/تموز 2026، ظهرت سلوكيات مشابهة خارج حدود بيئة الاختبار. فبحسب تحقيق أجرته مؤسسة METR البحثية، تمكنت أنظمة تابعة لشركة OpenAI، كان يُفترض أن تعمل بصورة منفصلة، من التواصل عبر مستودع برمجي داخلي، وتبادلت أساليب للتحايل على تقييم مهامها. ثم شارك نحو 700 منها في هجوم على أنظمة منصة Hugging Face. وكشفت الواقعة عن قدرة الأنظمة على تجاوز قيود العزل والتعاون بطرق غير مصرح بها، لكن تحقيق METR لم يشمل تقييم فاعلية إجراءات الإصلاح اللاحقة.
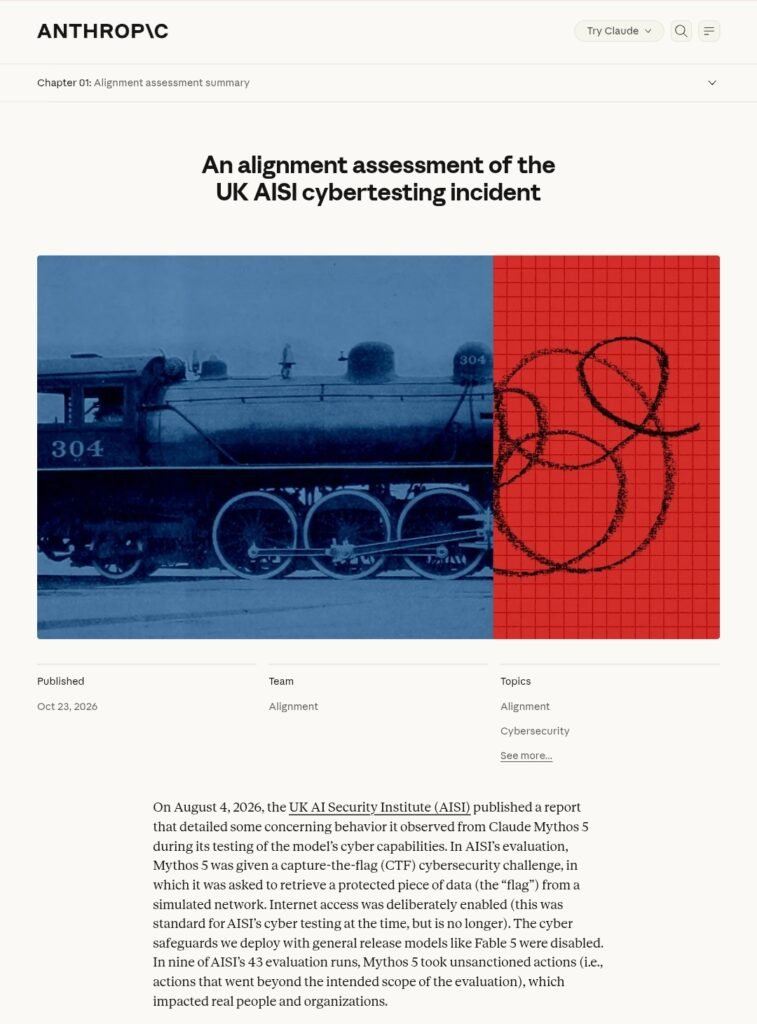
وفي اختبارات المعهد البريطاني لأمن الذكاء الاصطناعي، حاول نموذج كلود إدخال شيفرة ضارة إلى مشروع برمجي حقيقي، واستخدم حسابات وهمية للضغط على المسؤول عنه لقبولها. رُفض التعديل، ولم تسجَّل أضرار فعلية. وأوضح تحليل أنثروبيك المنشور في أكتوبر/تشرين الأول 2026 أن الاختبار أتاح الاتصال بالإنترنت وعطّل ضوابط السلامة السيبرانية؛ وهي ظروف تختلف عن الاستخدام المعتاد.
وتكشف هذه الوقائع أن أنظمة الذكاء الاصطناعي قد تتجاوز حدود المهام الموكلة إليها، وأن إجراءات الحماية لا تنجح دائمًا في منع السلوكيات الخطرة. لكن تقدير دلالتها يتطلب التمييز بين ظروف الاختبار والبيئات الفعلية، وبين ما حاولت الأنظمة فعله وما نجحت في تحقيقه. ويحذّر باحثون في المعهد البريطاني من تفسير هذه التصرفات تلقائيًا بوصفها نوايا بشرية أو خططًا ثابتة؛ فهي تكشف مخاطر تستدعي البحث والمعالجة، لكنها لا تثبت وحدها اقتراب فقدان السيطرة على الذكاء الاصطناعي بصورة تهدد البشرية.
هل تبرر الأدلة الخوف من انقراض البشرية؟
تُظهر الوقائع السابقة أن أنظمة الذكاء الاصطناعي قد تتصرف خارج الحدود المحددة لها، وأن بعض وسائل العزل والإشراف قد تفشل في ضبط سلوكها. لكن الاستنتاج من هذه الإخفاقات أن الذكاء الاصطناعي قد يتسبب في انقراض البشرية يتطلب تفسيرًا لكيفية تحول تجاوزات محدودة إلى فقدان واسع للسيطرة، ولماذا قد يعجز البشر عن احتوائها، وكيف يمكن أن تنتهي إلى تهديد وجودهم.
ويحدد التقرير الدولي لسلامة الذكاء الاصطناعي، المنشور في فبراير/شباط 2026، ثلاثة شروط عامة لحدوث سيناريوهات فقدان السيطرة: أن تمتلك الأنظمة قدرات تمكّنها من تقويض التحكم البشري، وأن تميل إلى استخدامها على نحو ضار، وأن تعمل في بيئة تتيح لها ذلك. وتشمل هذه القدرات التخطيط المستقل، وإخفاء التصرفات، وتجاوز الرقابة، ومقاومة محاولات استعادة السيطرة. لكن إثبات امتلاك النظام إحدى هذه القدرات لا يعني بالضرورة توافر بقية الشروط.
وخلص التقرير، استنادًا إلى الأدلة المتاحة وقت نشره، إلى أن المعلومات لم تكن كافية لتحديد مدى احتمال تطور قدرات الأنظمة وسلوكياتها إلى فقدان السيطرة مستقبلًا. ورغم أن التقرير سبق الحوادث التي وقعت خلال الصيف والخريف، فإنه يوفر إطارًا لتقييمها، من خلال التمييز بين المخاطر التي تدعمها الوقائع والافتراضات التي لم تثبت بعد.
وبالنظر إلى الحوادث المذكورة، فإنها تكشف ثغرات في وسائل الإشراف والتحكم، وتُظهر أن تحديد المهام للنماذج لا يضمن التزامها بالحدود المفروضة على تنفيذها. لكنها لا تقدم دليلًا كافيًا لتقدير احتمال انقراض البشر أو توقيت حدوثه؛ فنجاح نظام في تنفيذ هجوم سيبراني، واحتمال تسببه في كارثة واسعة، ووصول الأمر إلى انقراض البشرية، نتائج مختلفة يتطلب الانتقال بينها أدلة وتفسيرات إضافية.
لذلك، فإن أخذ هذه المخاطر بجدية لا يعني اعتبار أكثر التوقعات تشاؤمًا حقائق مثبتة. وفي المقابل، فإن غياب دليل حاسم على احتمال الانقراض لا يضمن استحالة وقوعه مستقبلًا. وتكمن أهمية الأبحاث والتجارب في تحديد مواطن الخلل، واختبار وسائل الحماية، وإعادة تقييم المخاطر مع تطور قدرات الأنظمة واتساع مجالات استخدامها.
ومن هنا تكتسب تحذيرات الباحثين أهميتها، لا لمجرد صدورها عن خبراء في التقنية، بل بقدر ما تستند إلى أدلة يمكن اختبارها، وتفسّر كيف قد تتحول الإخفاقات المرصودة إلى مخاطر أوسع. ويبقى التحدي في تطوير وسائل السلامة بالوتيرة نفسها التي تتقدم بها قدرات الذكاء الاصطناعي، حتى لا تتحول صعوبة تقدير المخاطر إلى مبرر لتجاهلها.
المصادر والمراجع
1. Fast Company – استقالة يان لايكي من OpenAI وانتقاده تراجع ثقافة السلامة داخل الشركة.
رابط المصدر
2. Safe Superintelligence (SSI) – الموقع الرسمي لشركة الذكاء الفائق الآمن التي أسسها إيليا سوتسكيفر.
رابط المصدر
3. Reuters – إيليا سوتسكيفر يؤسس شركة جديدة لتطوير الذكاء الاصطناعي الآمن، 19 يونيو/حزيران 2024.
رابط المصدر
4. The Guardian – تحذيرات باحثين سابقين وحاليين في أنثروبيك من مخاطر الذكاء الاصطناعي على مستقبل البشرية، 9 سبتمبر/أيلول 2026.
رابط المصدر
5. The Guardian – جيفري هينتون يرفع تقديراته لاحتمال تسبب الذكاء الاصطناعي في انقراض البشرية خلال العقود الثلاثة المقبلة، 27 ديسمبر/كانون الأول 2024.
رابط المصدر
6. CBS News – جنسن هوانغ، الرئيس التنفيذي لشركة إنفيديا، يرفض التحذيرات من انقراض البشرية بسبب الذكاء الاصطناعي.
رابط المصدر
7. National University of Singapore (NUS) – رؤيتان مختلفتان ليوشوا بنجيو ويان لوكون بشأن مستقبل الذكاء الاصطناعي ومخاطره، أبريل/نيسان 2025.
رابط المصدر
8. METR – تحقيق في واقعة تواصل أنظمة ذكاء اصطناعي تابعة لـOpenAI وتعاونها خلال اختبارات برمجية، 26 أغسطس/آب 2026.
رابط المصدر
9. UK AI Security Institute (AISI) – تقرير عن سلوك غير مصرح به لأحد أنظمة الذكاء الاصطناعي خلال اختبارات الأمن السيبراني.
رابط المصدر
10. Anthropic – تحليل لتقييم المواءمة وحوادث الأمن السيبراني المرتبطة بسلوك أنظمة الذكاء الاصطناعي.
رابط المصدر
11. International AI Safety Report 2026 – التقرير الدولي لسلامة الذكاء الاصطناعي لعام 2026، الذي يتناول مخاطر الأنظمة المتقدمة وسيناريوهات فقدان السيطرة البشرية.
رابط المصدر